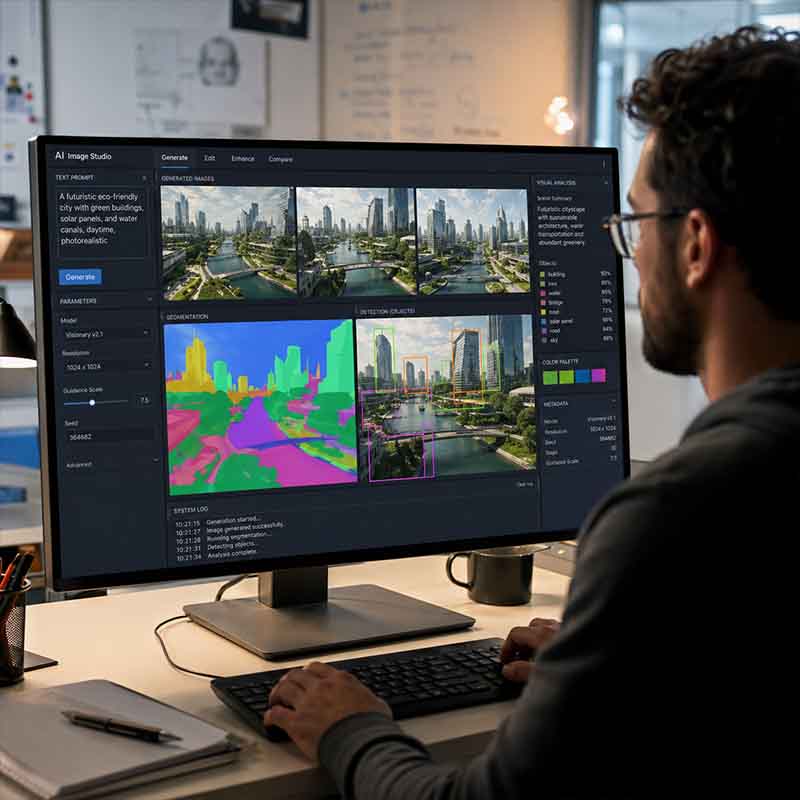
Vision Banana е едно от най-интересните нови изследвания в областта на изкуствения интелект, защото поставя под въпрос старата граница между два различни типа AI системи: тези, които създават изображения, и тези, които ги разбират. Досега генераторите на изображения обикновено се възприемаха като инструменти за визуално съдържание – например за създаване на снимки, илюстрации или редакции по текстова инструкция. Новият подход на Google DeepMind обаче показва, че един модел, обучен да генерира изображения, може да бъде използван и за задачи, които традиционно принадлежат към компютърното зрение.
Изследването е публикувано под заглавието „Image Generators are Generalist Vision Learners“ и представя Vision Banana като модел, изграден върху Nano Banana Pro, който е дообучен с инструкции и малко количество данни за визуални задачи. Според описанието на Google DeepMind моделът използва генерирането на изображения като универсален интерфейс за различни задачи – от сегментация до оценка на дълбочина и повърхностни нормали.
Какво е Vision Banana и защо е важен
Vision Banana не е просто пореден AI генератор на картинки. По-правилно е да се опише като изследователски модел за визуално разбиране, който използва силата на генеративния AI по нов начин. Вместо да добавя отделни специализирани модули за всяка задача, моделът преобразува резултатите от компютърното зрение в RGB изображения. Според официалната публикация на Google DeepMind за Vision Banana, моделът е изграден върху Nano Banana Pro и е дообучен с инструкции, за да изпълнява различни задачи за визуално разбиране.
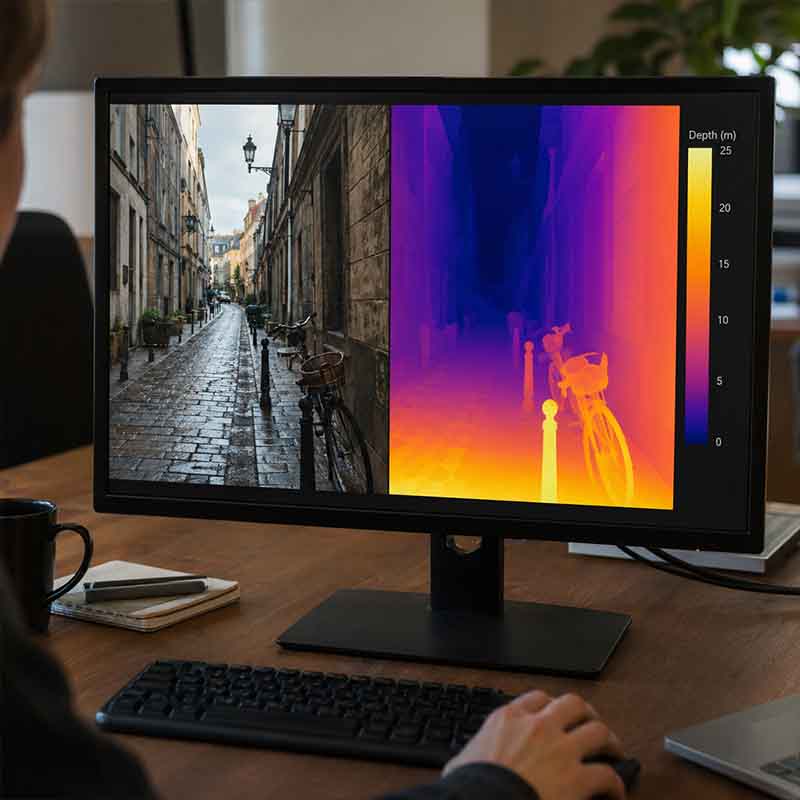
Това звучи технически, но идеята е сравнително лесна за разбиране. Ако моделът трябва да направи сегментация, той не връща таблица с числа или класически машинен изход. Вместо това създава цветна карта, в която различните обекти или зони са отбелязани с различни цветове. Ако задачата е оценка на дълбочина, моделът генерира изображение, в което цветовете показват колко далеч се намират обектите в сцената.
Този подход е важен, защото обединява две посоки в AI развитието: създаване и разбиране. Досега често се приемаше, че моделите за генериране на изображения са добри в „рисуването“, но не непременно в анализа. Vision Banana показва, че при правилно дообучаване един генеративен модел може да извади на повърхността знания за форма, пространство, обекти и сцени.
Място за хипервръзка 1:
В края на горния абзац може да вмъкнеш това изречение:
„Повече подробности за модела са описани в официалната публикация на Google DeepMind за Vision Banana.“
Хипервръзка върху: официалната публикация на Google DeepMind за Vision Banana.
Vision Banana и идеята, че генераторите „разбират“ изображения
Голямата теза в изследването е, че обучението за генериране на изображения може да играе роля, подобна на предварителното обучение при големите езикови модели. При езиковите модели системата първо се учи да предвижда и генерира текст, а след това чрез инструкции се настройва за конкретни задачи. Според авторите нещо подобно може да се случи и при визуалните модели.
Когато един AI модел се учи да създава реалистични изображения, той не запаметява само цветове и текстури. За да генерира убедителна сцена, той трябва косвено да усвои връзки между предмети, перспектива, светлина, дълбочина, размери и контекст. Например, ако моделът трябва да създаде улица с автомобили, пешеходци и сгради, той трябва да има някакво вътрешно разбиране за това къде стоят обектите, как се припокриват и как изглежда реална градска среда.
Vision Banana използва точно тази скрита способност. Чрез instruction-tuning, или дообучаване с инструкции, моделът се насочва да представя визуалното си разбиране в конкретен формат. Това не означава, че моделът „разбира“ като човек, но означава, че неговите вътрешни представи могат да бъдат полезни за сериозни компютърни задачи.
Как работи Vision Banana
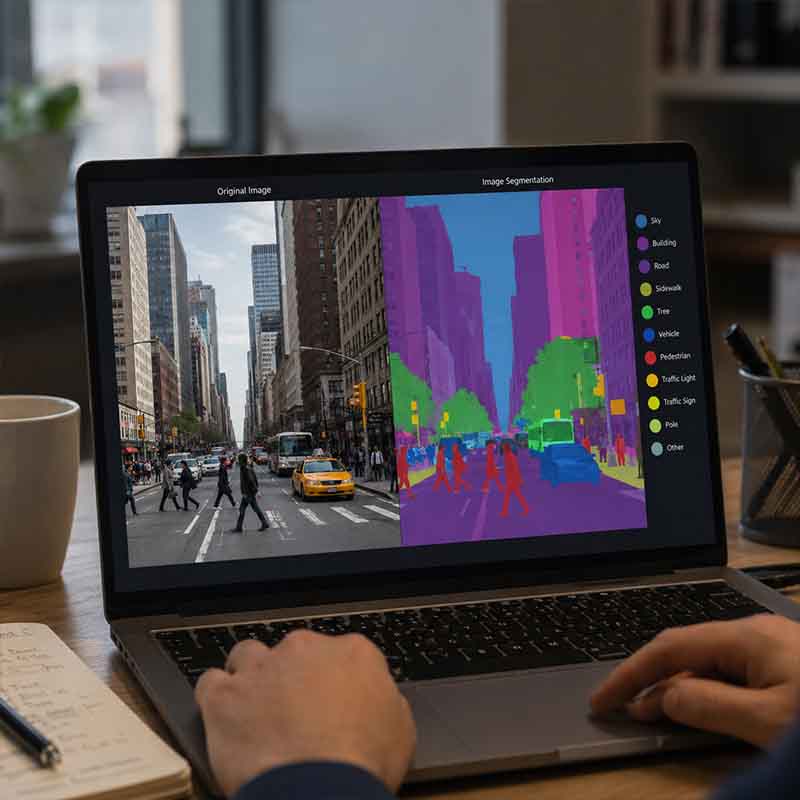
Най-интересното в Vision Banana е, че различните задачи се представят като задачи за генериране на изображение. При семантична сегментация моделът може да получи инструкция да оцвети различните категории обекти в различни цветове. При instance segmentation той трябва да различи отделни обекти от един и същи тип – например няколко коли, няколко човека или няколко предмета на маса. В научния доклад, публикуван в arXiv, авторите описват как Vision Banana превръща задачи като сегментация и оценка на дълбочина в изображения, което позволява един модел да се използва за различни визуални задачи.
При оценка на дълбочина задачата е още по-сложна. Моделът трябва да предвиди колко далеч са различните части на сцената само от едно изображение. Това е трудно, защото обикновената снимка няма директна информация за реалното разстояние. Въпреки това Vision Banana използва визуални подсказки като перспектива, размер на обектите, подредба в сцената и натрупаното знание от генеративното обучение.
В arXiv доклада се посочва, че Vision Banana е тестван върху задачи за 2D и 3D визуално разбиране, включително семантична сегментация, сегментация по текстово описание, оценка на метрична дълбочина и surface normal estimation. Авторите подчертават, че моделът използва общ подход, при който само инструкциите се променят, а не се добавят отделни архитектури за всяка задача.
Място за хипервръзка 2:
След горния абзац може да вмъкнеш това изречение:
„Техническите резултати и сравнителните тестове са описани подробно в научния доклад, публикуван в arXiv.“
Хипервръзка върху: научния доклад, публикуван в arXiv.
Какви резултати показва моделът
Според публикуваните резултати Vision Banana се представя силно в няколко области, които досега се доминираха от специализирани модели. В доклада са посочени сравнения със системи като Segment Anything Model 3, Depth Anything 3 и Lotus-2. При някои задачи Vision Banana надминава или достига нивото на тези специализирани решения, въпреки че е изграден върху генеративен модел.
Особено впечатляваща е идеята, че моделът може да се справя със задачи за сегментация и дълбочина без да бъде проектиран само за тях. Това е важна разлика. Много класически системи за компютърно зрение са оптимизирани за една конкретна задача. Vision Banana показва по-гъвкав подход, при който един модел може да бъде използван за няколко различни типа визуално разбиране.
Въпреки това е добре резултатите да се разглеждат внимателно. Става дума за изследователски модел и научна публикация, а не за готов потребителски продукт, който всеки може веднага да използва в ежедневна работа. Това прави темата още по-интересна, защото показва посоката, в която може да се развие компютърното зрение през следващите години.
Защо това може да е важен завой в AI развитието
Ако подходът на Vision Banana се потвърди и развие, той може да промени начина, по който се създават модели за компютърно зрение. Вместо отделни системи за сегментация, дълбочина, редактиране, разпознаване и визуално разсъждение, бъдещите AI модели може да бъдат по-унифицирани. Един основен визуален модел ще може да приема различни инструкции и да връща различен тип резултати.
Това напомня на начина, по който големите езикови модели започнаха да изпълняват много задачи с един и същ интерфейс. Потребителят задава инструкция, а моделът връща отговор в желания формат. Vision Banana прилага подобна логика, но при изображенията. Вместо текстов отговор, резултатът често е ново изображение, карта, маска или визуална интерпретация.
За бизнеса и разработчиците това може да означава по-малко сложни системи. За научните екипи – нов начин за оценяване на генеративните модели. За потребителите – бъдещи инструменти, които не само създават снимки, но и могат да ги анализират по-дълбоко.
Какво означава това за обикновения потребител
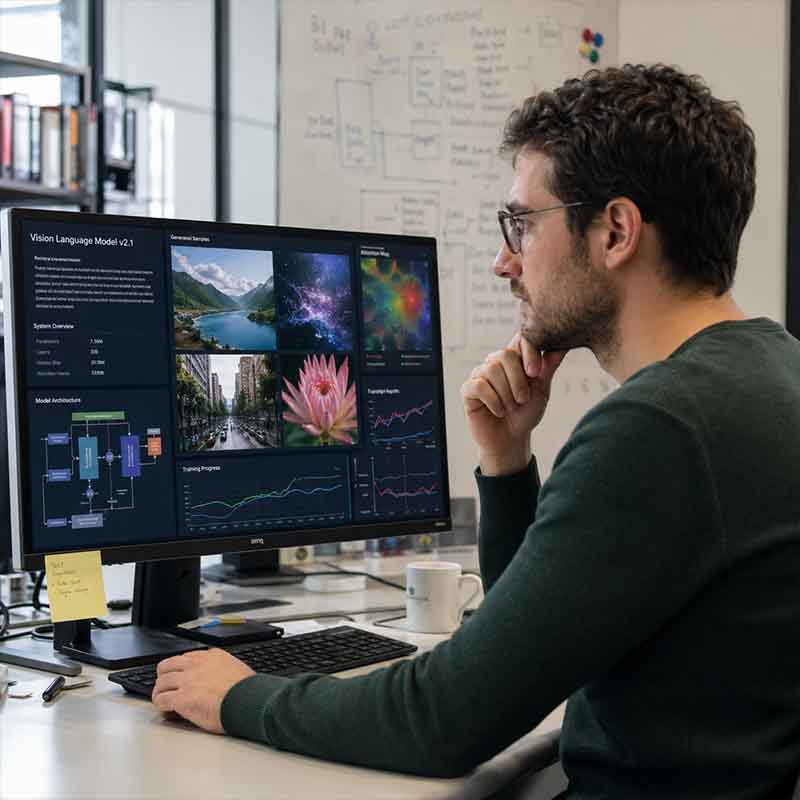
За обикновения човек Vision Banana може да звучи като далечна лабораторна тема, но подобни изследвания често стигат до реални продукти под различна форма. Ако един AI модел може да разбира изображения по-добре, това може да подобри търсенето в снимки, редактирането на изображения, медицинската визуализация, роботиката, автомобилните системи, картографирането и инструментите за дизайн.
Представете си програма, която не просто премахва фон, а разбира къде започва човекът, къде е сянката, каква е дълбочината на сцената и кои обекти са важни. Или AI асистент, който може да анализира снимка от пътя, строителен обект, магазин или производствена линия и да даде по-точна визуална информация. Точно такива възможности стоят зад развитието на по-общи визуални модели.
Има ли ограничения и рискове
Да, и те не трябва да се пропускат. Vision Banana показва обещаващи резултати, но това не означава, че всички проблеми са решени. Генеративните модели могат да бъдат изчислително тежки. Това означава, че използването им в реални приложения може да бъде по-скъпо или по-бавно от по-малки специализирани модели.
Има и въпрос за надеждността. При задачи като дълбочина, сегментация или анализ на сцени грешките могат да бъдат важни. Ако AI модел се използва в медицина, автономно движение или индустриална безопасност, резултатите трябва да бъдат проверени много внимателно. Затова Vision Banana е важен като научна стъпка, но не бива да се представя като магическо решение за всички визуални задачи.
Също така трябва да се прави разлика между лабораторни резултати и реални условия. Един модел може да се представя отлично на бенчмаркове, но да има трудности при лошо осветление, странни ъгли, шумни изображения или необичайни обекти.
Какво следва след Vision Banana
Следващата голяма стъпка вероятно ще бъде проверка дали този подход може да стане по-бърз, по-евтин и по-лесен за интегриране. Ако генеративните визуални модели наистина могат да служат като основа за различни задачи, разработчиците ще търсят начини да ги използват в реални приложения без огромен разход на изчислителни ресурси.
Възможно е също така да видим повече конкуренция между модели, които създават изображения, и специализирани модели за компютърно зрение. Вместо едните да заменят другите веднага, по-вероятно е в близко бъдеще да има хибриден подход. Генеративните модели ще дават гъвкавост и разбиране, а специализираните системи ще продължат да бъдат полезни там, където скоростта, цената и точността са решаващи.
Заключение
Vision Banana е силен сигнал, че изкуственият интелект навлиза в нов етап на визуално разбиране. Най-важната идея не е само, че моделът постига добри резултати на отделни тестове. По-важното е, че Google DeepMind показва различна философия: генераторите на изображения може да не са просто инструменти за създаване на визуално съдържание, а основа за по-широко компютърно зрение.
Ако тази посока се развие успешно, бъдещите AI системи ще могат едновременно да създават, редактират и анализират изображения с много по-голяма гъвкавост. Vision Banana все още е изследователски модел, но идеята зад него е достатъчно важна, за да привлече вниманието на цялата технологична общност. Той показва, че следващата голяма битка в AI може да не бъде само кой модел рисува по-красиво, а кой модел наистина разбира какво вижда.
Материал, подготвен от екипа на Mushmurok
Тази статия е изготвена от редакционния екип на Mushmurok с цел да предостави полезна, актуална и оригинална информация за читателите ни. Анализирахме пазарни тенденции, потребителски отзиви и публично достъпни данни, за да създадем обективен и практичен преглед.
Нашата мисия: Помагаме на българските семейства и бизнеси да вземат информирани решения чрез проверена информация, представена ясно и достъпно.
Преработено и оригинално съдържание – събрано, анализирано и обобщено от експертния ни екип за вашето удобство.
Венцо ИГ е автор и редактор на Mushmurok.com. Той подготвя, редактира и актуализира съдържанието в сайта, като се стреми да представя информацията ясно, практично и разбираемо. Пише по теми, свързани с автомобили и електромобили, технологии, полезни съвети, рецепти, растения и ежедневие. При материали, основани на външна информация, използва надеждни и официални източници. Венцо ИГ отговаря за окончателната редакция, проверката и актуализирането на публикациите в Mushmurok.com.